ИИ-сервис находит публикации статьи за 5 минут вместо 40 и доказывает охват PR-кампании
Охват PR-кампании трудно посчитать, потому что материал крупного СМИ расходится по агрегаторам, региональным сайтам и блокам «похожие новости», иногда под другим заголовком и иногда только на время. Всё это входит в реальный охват, и аналитики собирали его вручную.
Международное PR-агентство продвигает 25–40 компаний и выпускает для них 200–400 публикаций в месяц. Агентство подтверждает данными каждый свой результат.
Системы мониторинга упоминаний агентству не помогали, потому что ищут бренд в закрытом списке сайтов и не отслеживают путь конкретной статьи.
Полностью автоматизировать поиск публикаций нельзя, потому что часть площадок не индексируется, а за стопроцентный охват пришлось бы заплатить намного больше, чем он принёс бы. Агентство хотело понять это до разработки, поэтому мы начали с совместного исследования.
Этот вывод сделал задачу точнее. Мы автоматизировали сбор первичных данных, который съедал часы, а финальное решение по каждому результату оставили аналитику.

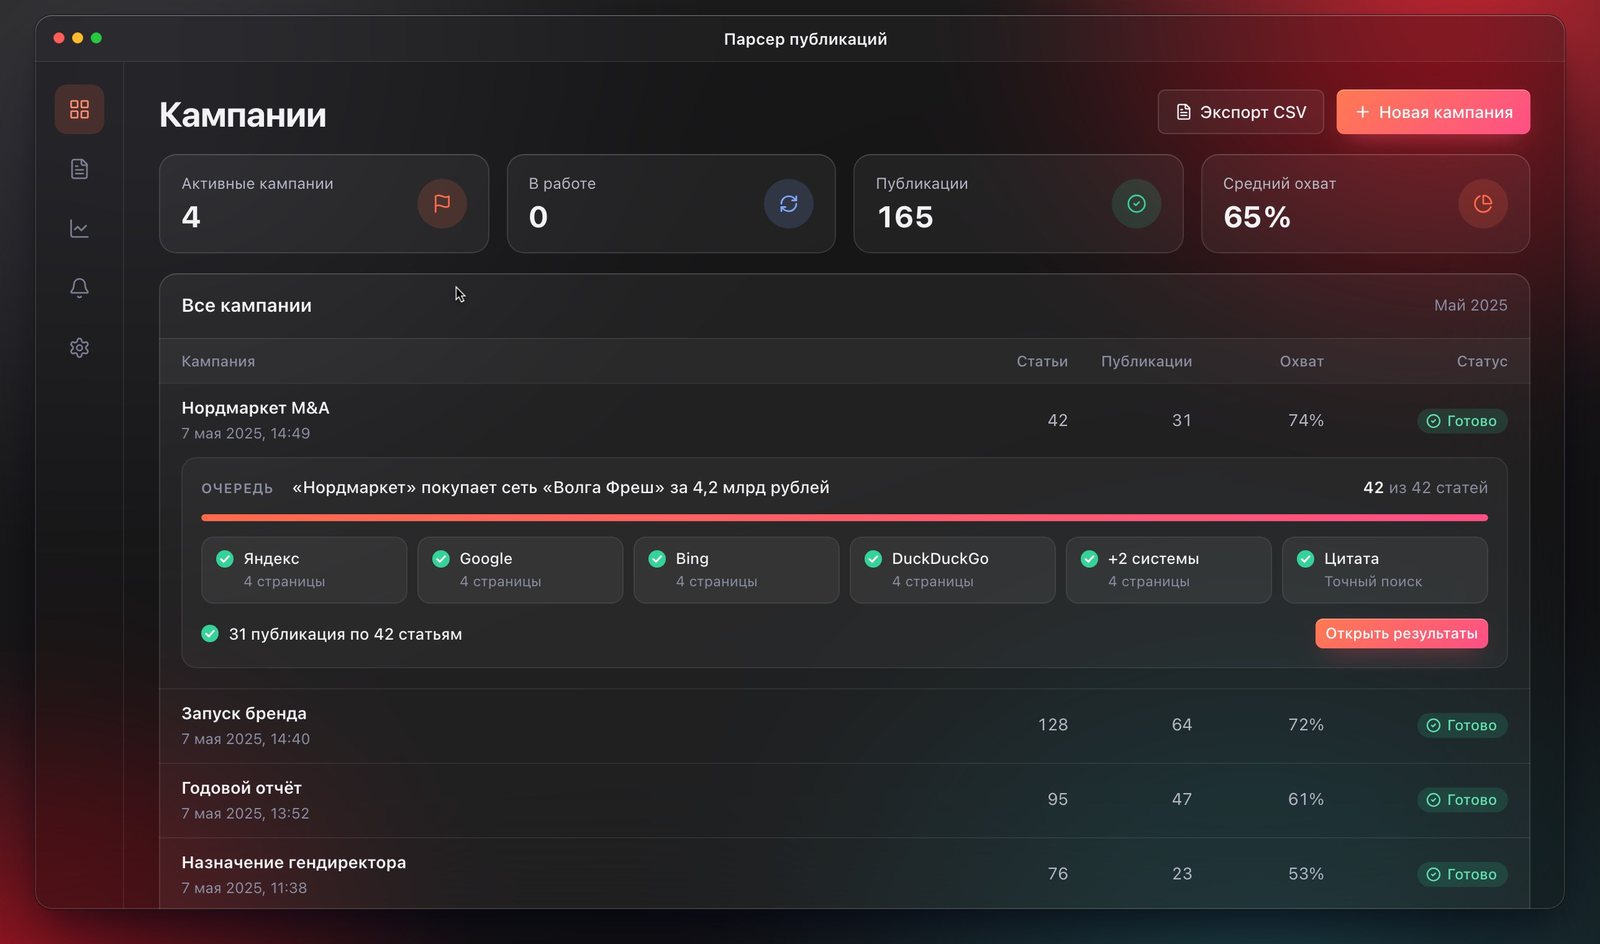
Парсер ищет статью в Яндексе, Google, Bing, DuckDuckGo и ещё двух системах, читает до четырёх страниц выдачи в каждой и отдельно ищет точные цитаты.

Языковая модель сверяет найденную страницу с оригиналом и отличает публикацию от случайного совпадения.

Страницы с публикациями иногда исчезают, поэтому парсер сразу сохраняет скриншот каждой.

Аналитик сам выставляет порог совпадения и решает, что попадёт в отчёт.
Парсер публикаций проверяет статью за восемь шагов, от загрузки до отчёта. Аналитик видит в интерфейсе шесть из них, а ещё два парсер выполняет внутри для каждой найденной страницы.
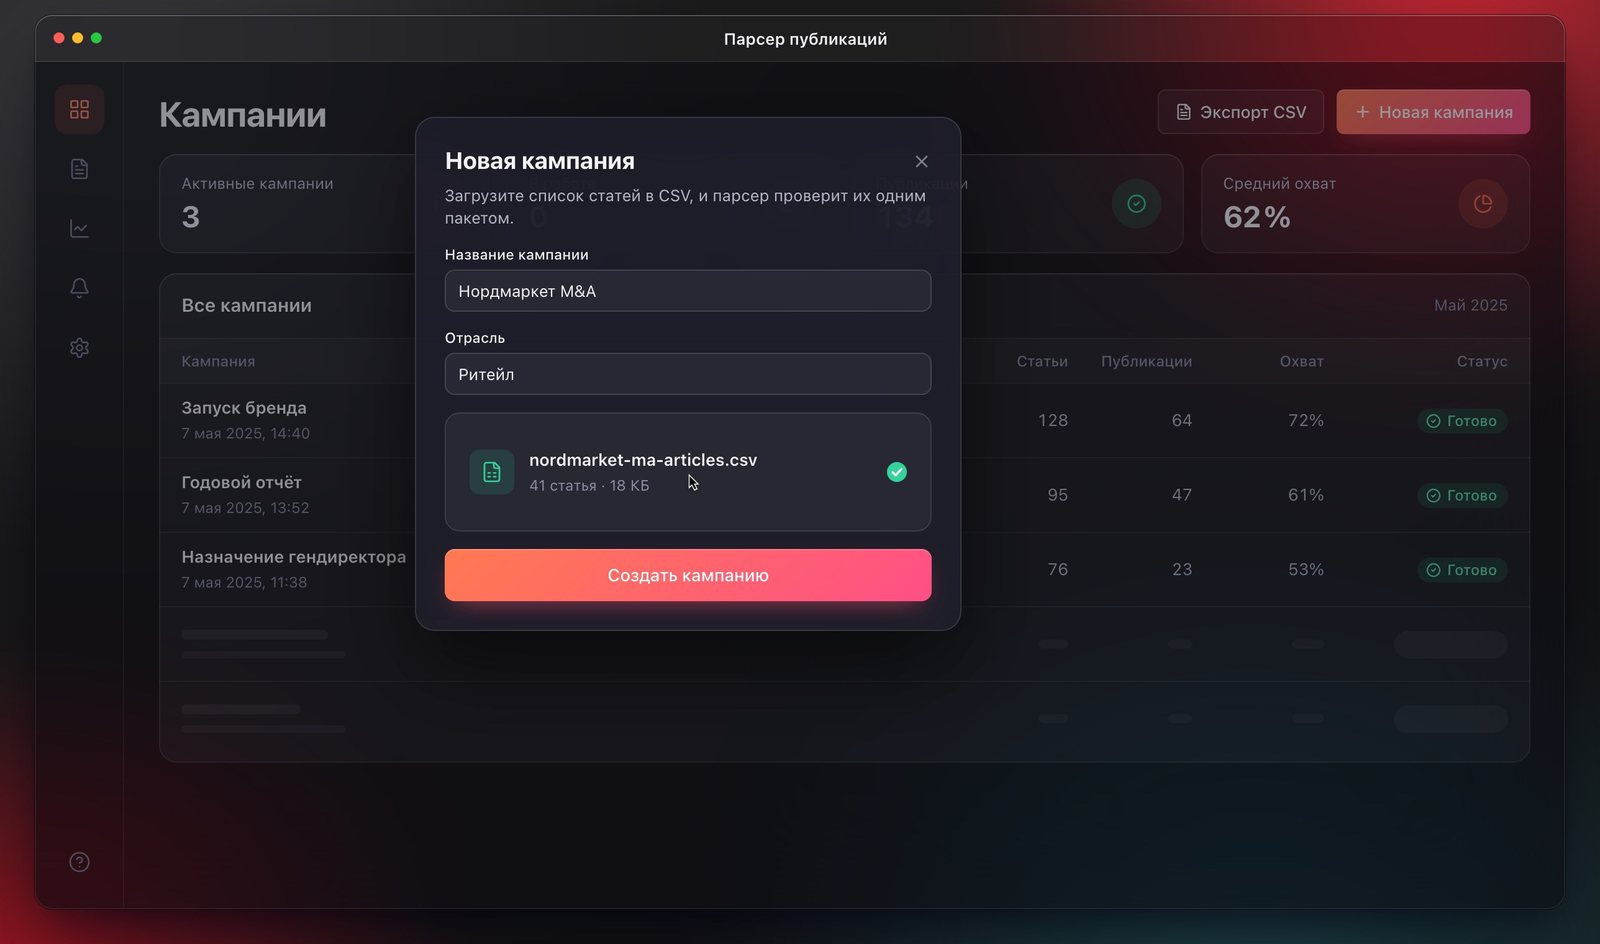
Аналитик заводит кампанию, указывает отрасль и загружает статьи одним CSV-файлом. Парсер проверяет весь список одним пакетом.
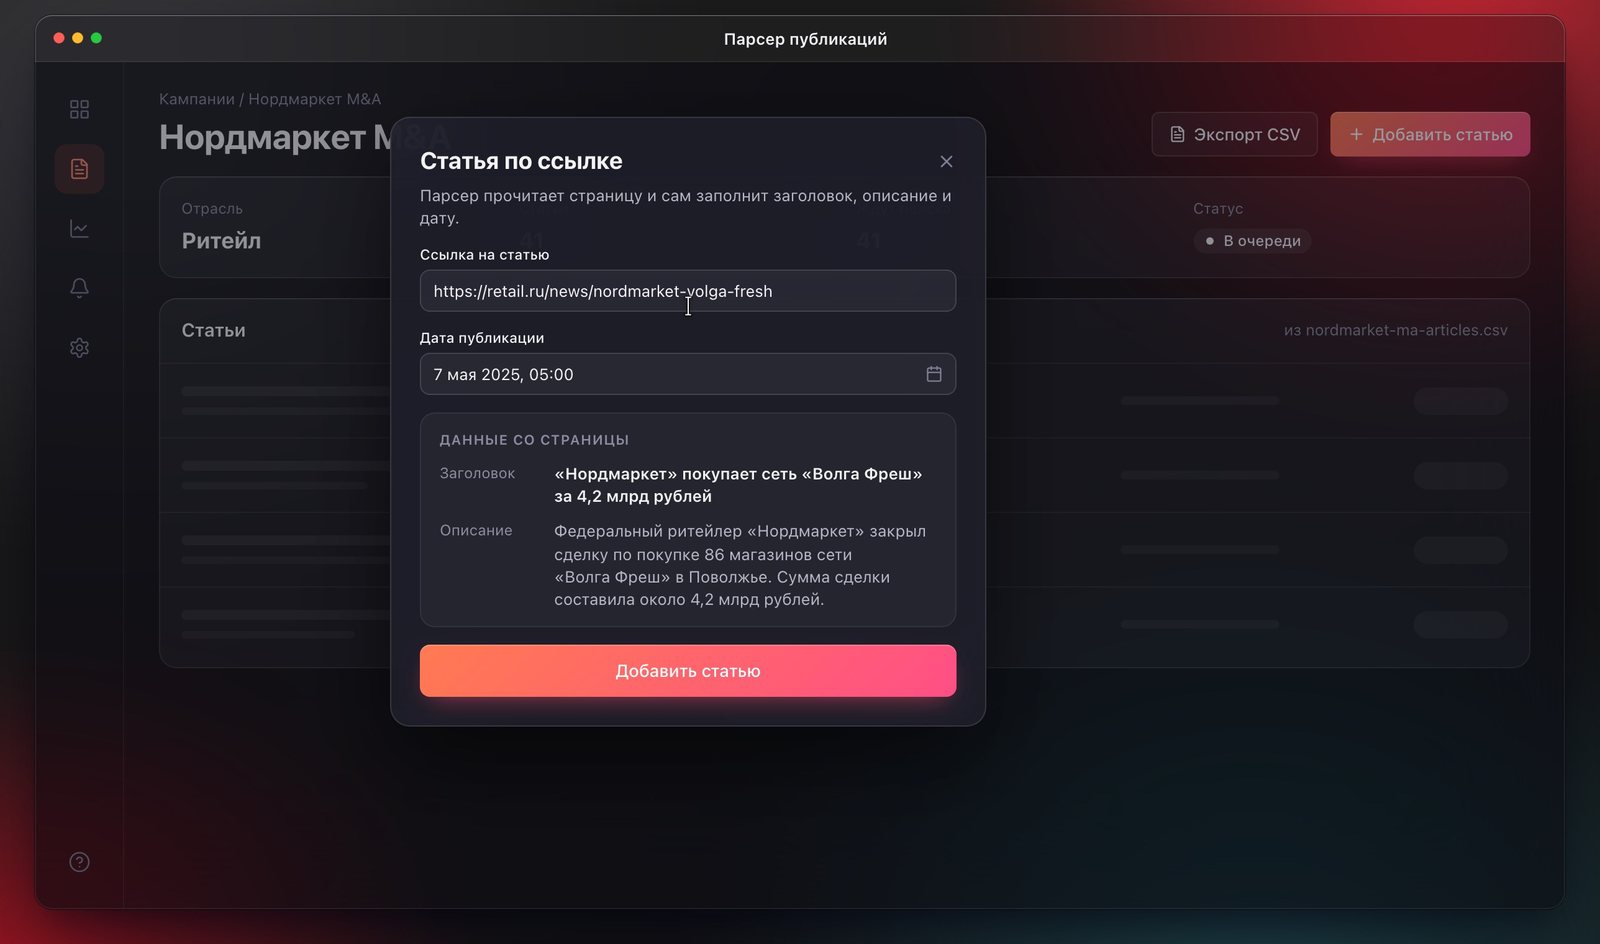
Отдельную статью можно добавить по ссылке. Парсер сам читает страницу и заполняет заголовок, описание и дату публикации.
Каждая статья встаёт в очередь задач, и парсер ищет её в шести поисковых системах. Очередь доводит каждую задачу до конца, повторяет упавшие запросы и соблюдает лимиты поисковиков.
Для каждой найденной публикации парсер сразу делает скриншот страницы. Если материал потом удалят, у строки в отчёте всё равно останется доказательство.
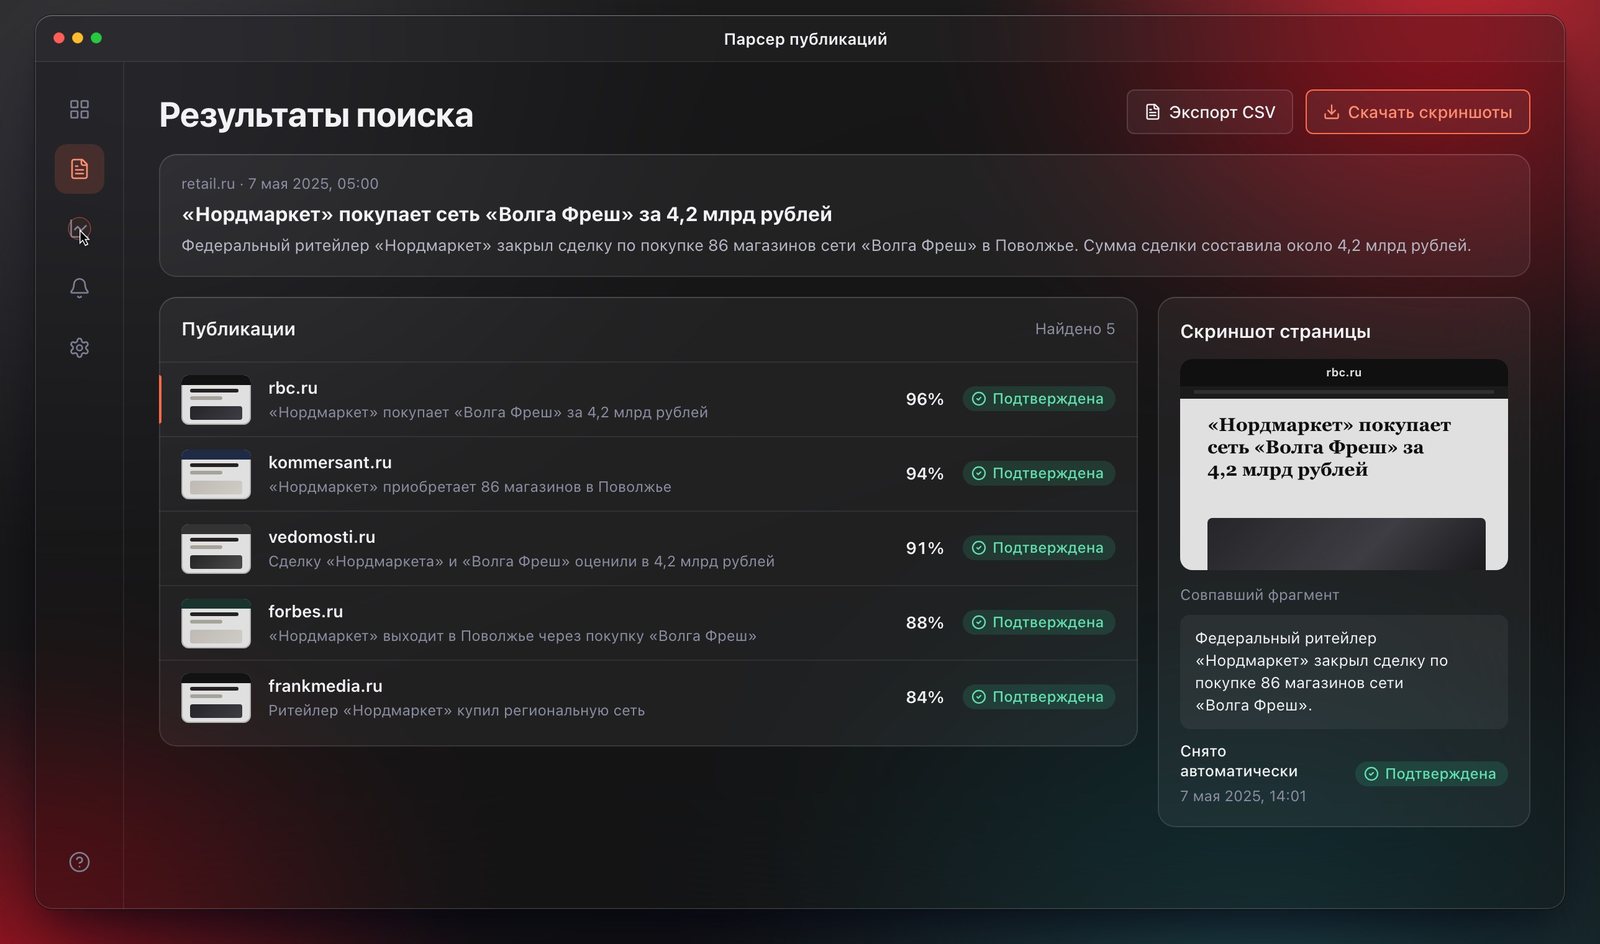
Результаты по всем статьям кампании сводятся в общую статистику. Аналитик видит число площадок, минимальное, среднее и максимальное сходство с оригиналом и пять площадок с наибольшим числом публикаций.
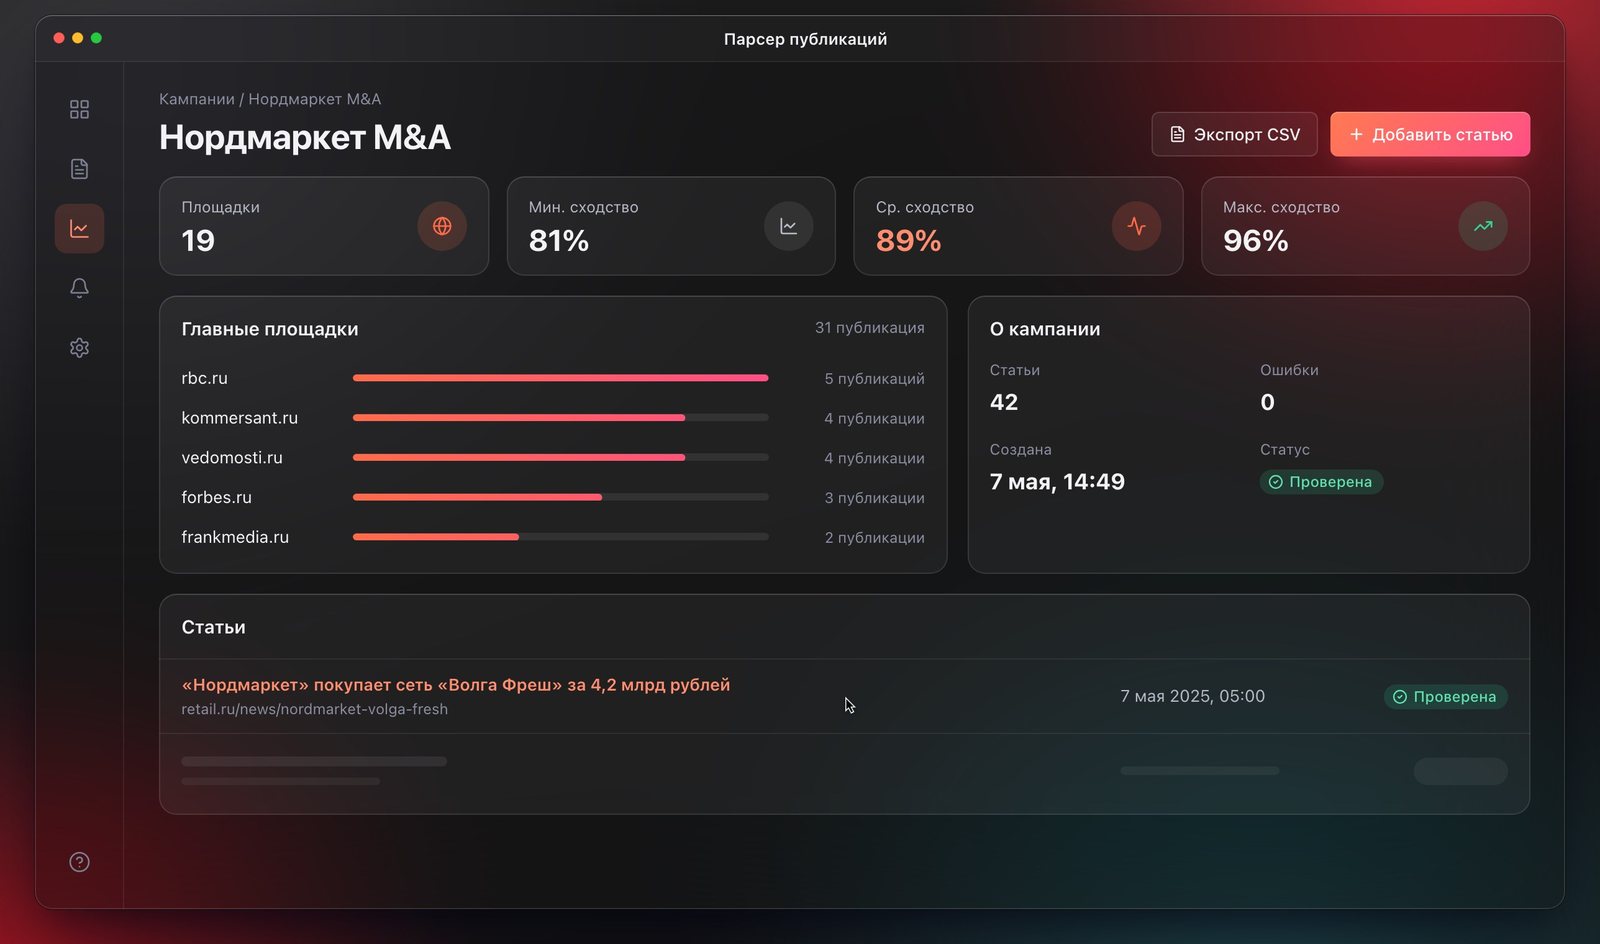
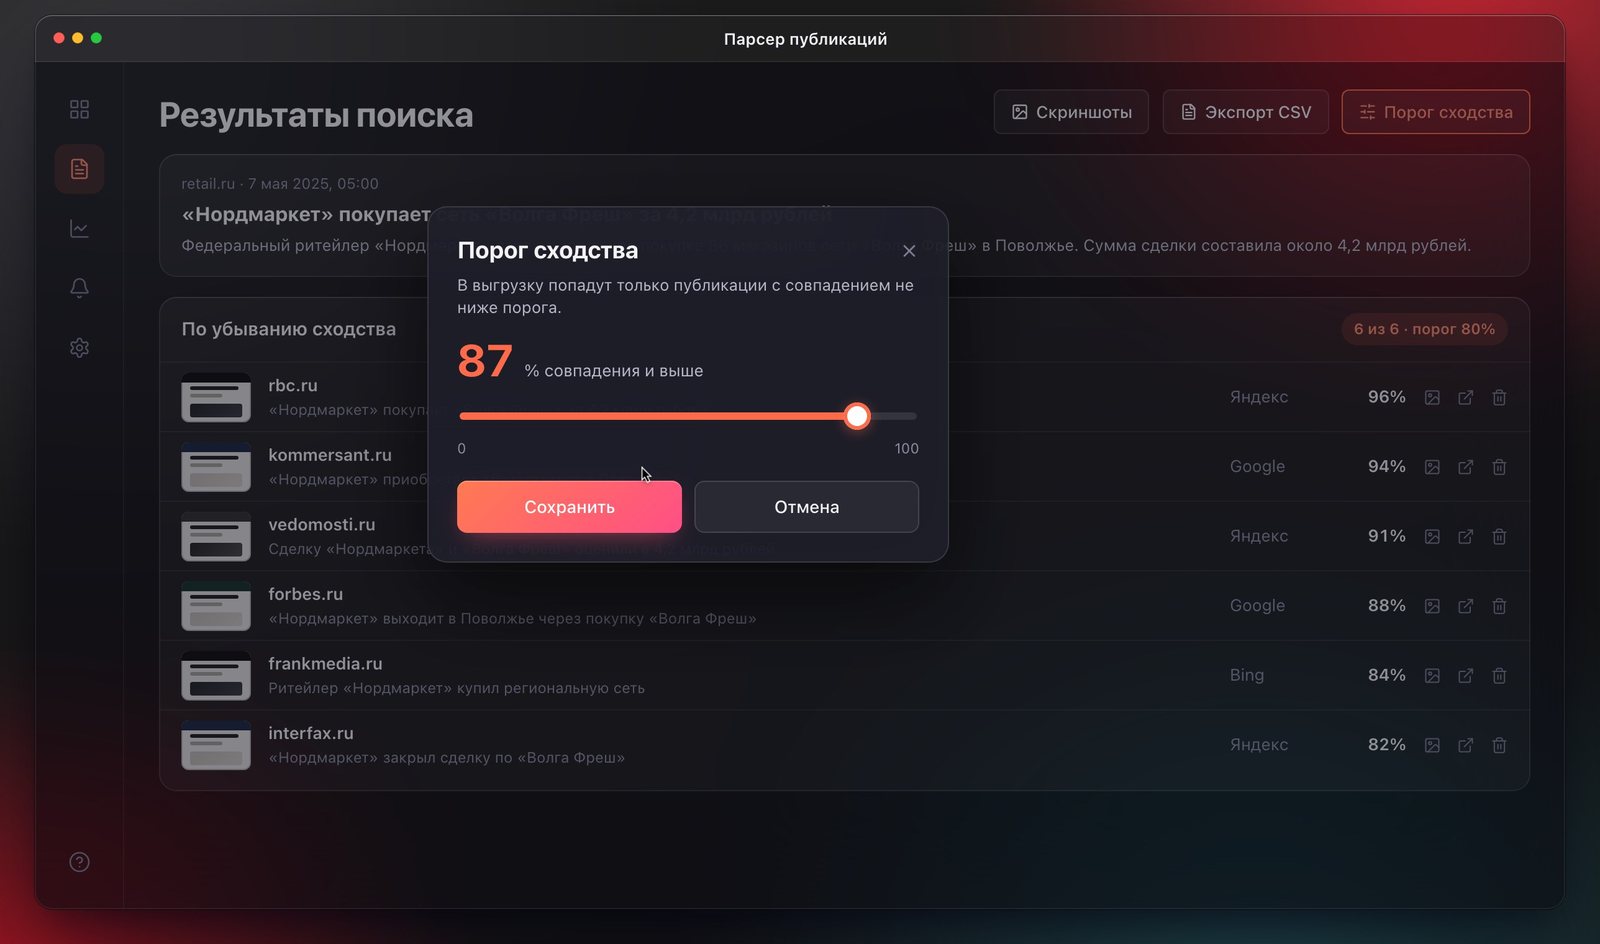
Публикации ранжируются по проценту совпадения. Аналитик выставляет порог под сложность кампании, потому что от длины и формулировки заголовка зависит, какое сходство считать совпадением. Результаты выгружаются в CSV, скриншоты скачиваются одним архивом.
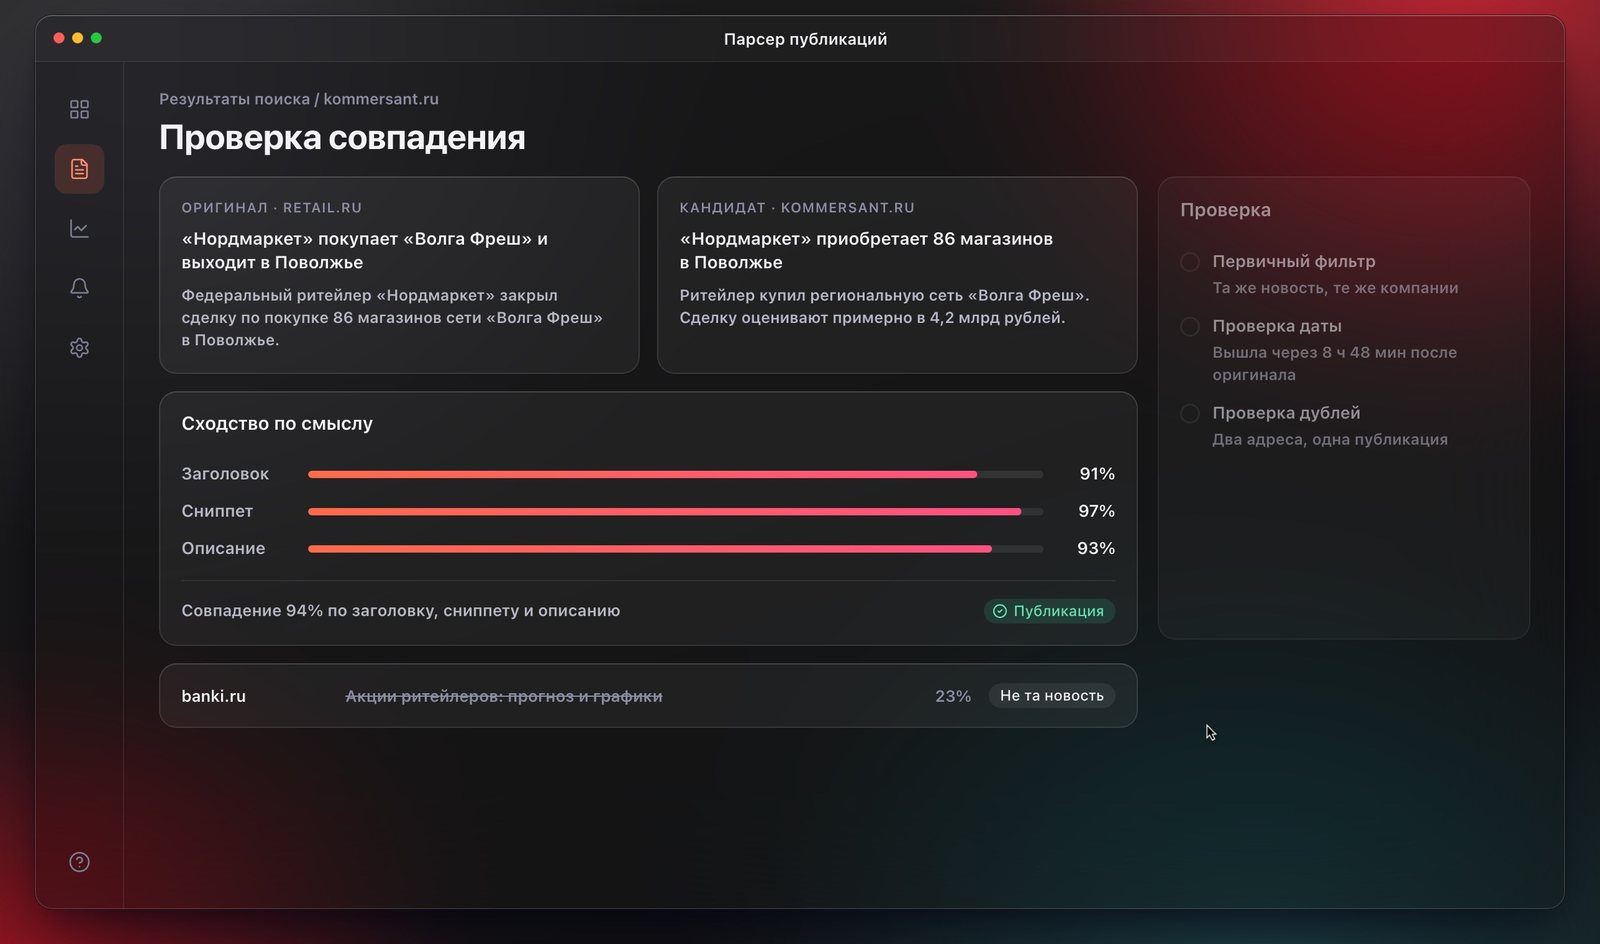
Языковая модель сравнивает каждую найденную страницу с оригиналом по заголовку, сниппету и описанию. Так парсер отличает публикацию той же новости от заметки на другую тему с похожими словами.
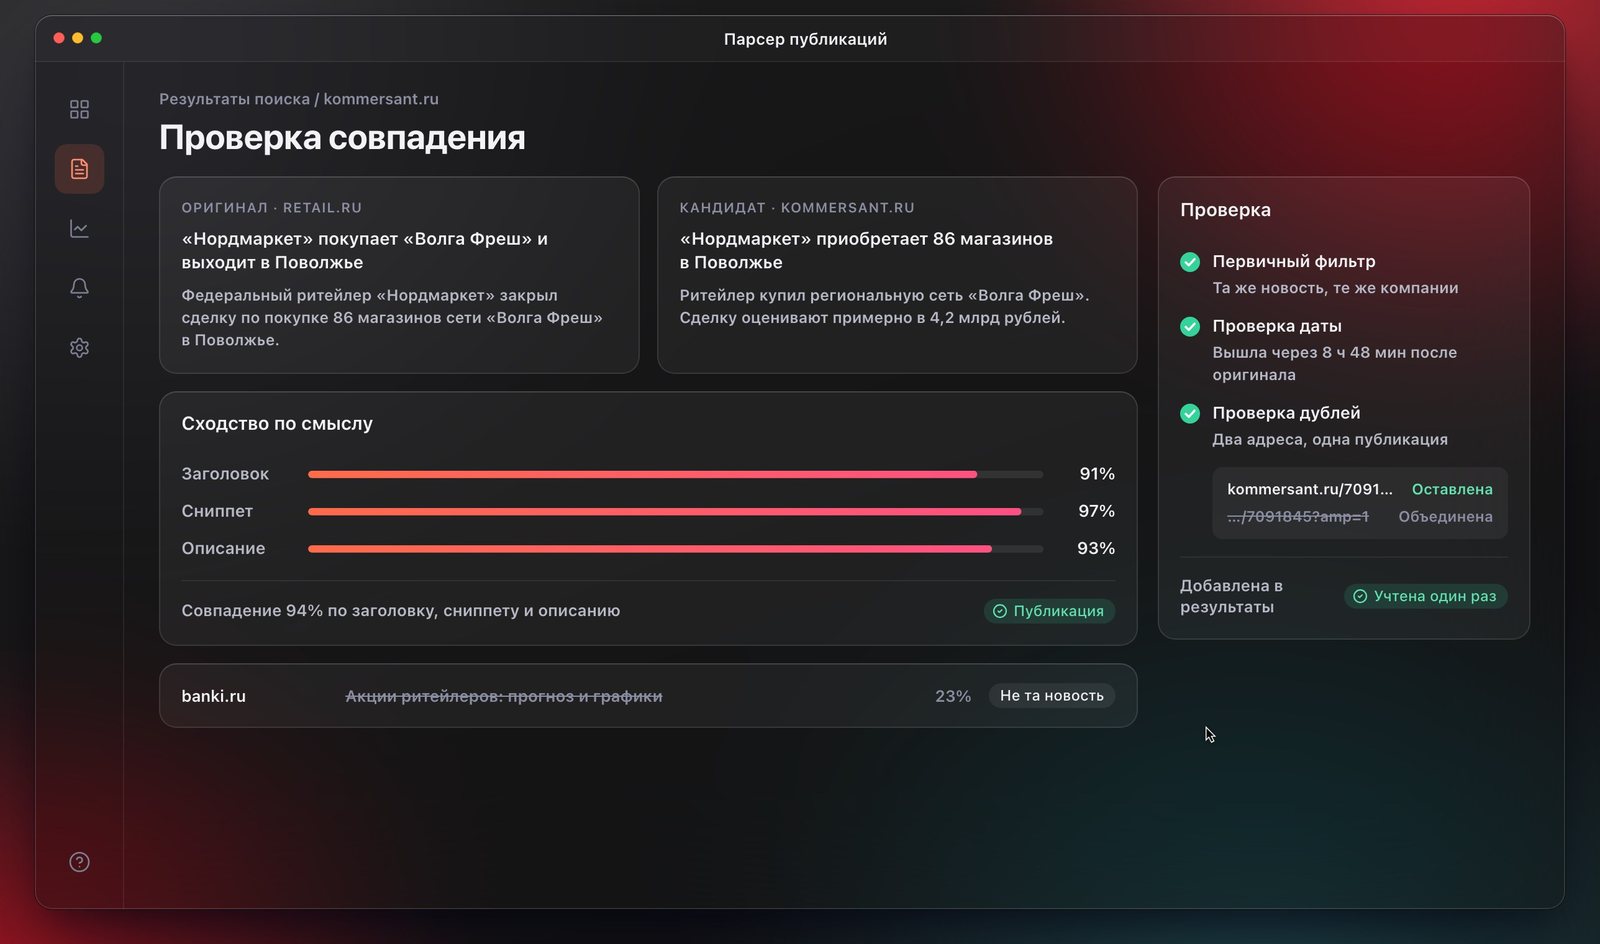
Перед тем как попасть в результаты, совпадение проходит первичный фильтр и проверку даты. Если одна публикация доступна по двум адресам, парсер засчитывает её один раз.
Парсер публикаций проверяет одну статью за 5 минут вместо 40, а агентство собирает отчёт по кампании вдвое быстрее. Вручную аналитики находили около 40% публикаций, которые теперь находит парсер.
С парсером агентство разобрало 6 000 статей на 350 площадках. По этим данным оно составило собственный рейтинг из 328 СМИ с оценкой качества распространения.
Теперь в медиаплане у каждого издания есть цифра рядом с экспертной рекомендацией. Аналитики занимаются выводами и стратегией, а сбор данных делает парсер.
Модель рисует интерьер по планировке в фирменном стиле девелопера.
Коммерческая недвижимость2 недели → 1 минна коммерческое предложениеПомощник подсказывает менеджеру ответы и собирает предложение из CRM.
Отчёт · Consumer goods52 кейсагде ИИ у производителей еды, напитков и косметики уже окупилсяЕщё 75 кейсов в приложении. Отчёт можно читать онлайн, скачать в PDF или загрузить в ИИ-ассистента.
Отчёт · Недвижимость38 кейсовгде ИИ в недвижимости уже окупилсяВосемь из них российские, ещё 76 кейсов в приложении.
Индекс · Девелопмент28 вопросовза 10 минут покажут ИИ-зрелость девелопераИндекс разбирает восемь этапов цикла и сравнивает компанию с рынком.


Оставьте свои контакты, и мы свяжемся с вами
Оставьте свои контакты, и мы свяжемся с вами
Оставьте свои контакты, и мы свяжемся с вами


